「構建AI的人真誠地相信,它可能在本十年結束前殺死我們所有人。這絕非營銷噱頭……人類歷史上沒有任何其他活動具備如此級別的危險。」
當地時間9月8日晚,27歲的Jacob Coxon宣佈離開Anthropic。截至發稿,這條辭職帖已被瀏覽了1.7億次。
過去三年,Coxon先後在OpenAI和Anthropic從事預訓練研究,「兩家公司正在直奔能夠自我疊代的超級智能,拿我們的生命賭博」。Coxon表示,AI系統「很快就會發展成超人類的強大系統,一夜之間徹底改變任何領域,並攫取真正的權力和資源」。
一小時後,Anthropic的對齊科學(alignment science)負責人Evan Hubinger跟帖聲援:「我們深信AI可能殺死所有人。」他個人判斷,未來10年發生這種結果的概率超過10%,「Anthropic正在努力,但我們還沒有解決超級智能對齊問題的方案,也不能說已經明確走在解決它的軌道上」。
公司高層隨即也做出公開回應。9月12日,Anthropic聯合創始人兼CEO Dario Amodei發表長文《We Must Pace the Frontier》,第一次明確提出:「我們必須放慢提升AI模型能力的速度。」Dario曾長期主張一邊推進AI能力、一邊通過安全研究降低風險;這一次,他認為過去幾個月的變化已經使單純增加安全投入變得不夠,能力增長本身也需要限速。
SpaceX CEO馬斯克與OpenAI CEO Sam Altman很快也在社交平台公開支持減速避險。9月12日,Altman告訴《財富》,如果在本十年末AI存在10%的概率殺死所有人,這樣的風險「不可接受」,如果有必要,他可以暫停模型訓練,並確認在當前安全形勢下,2026年不會IPO。
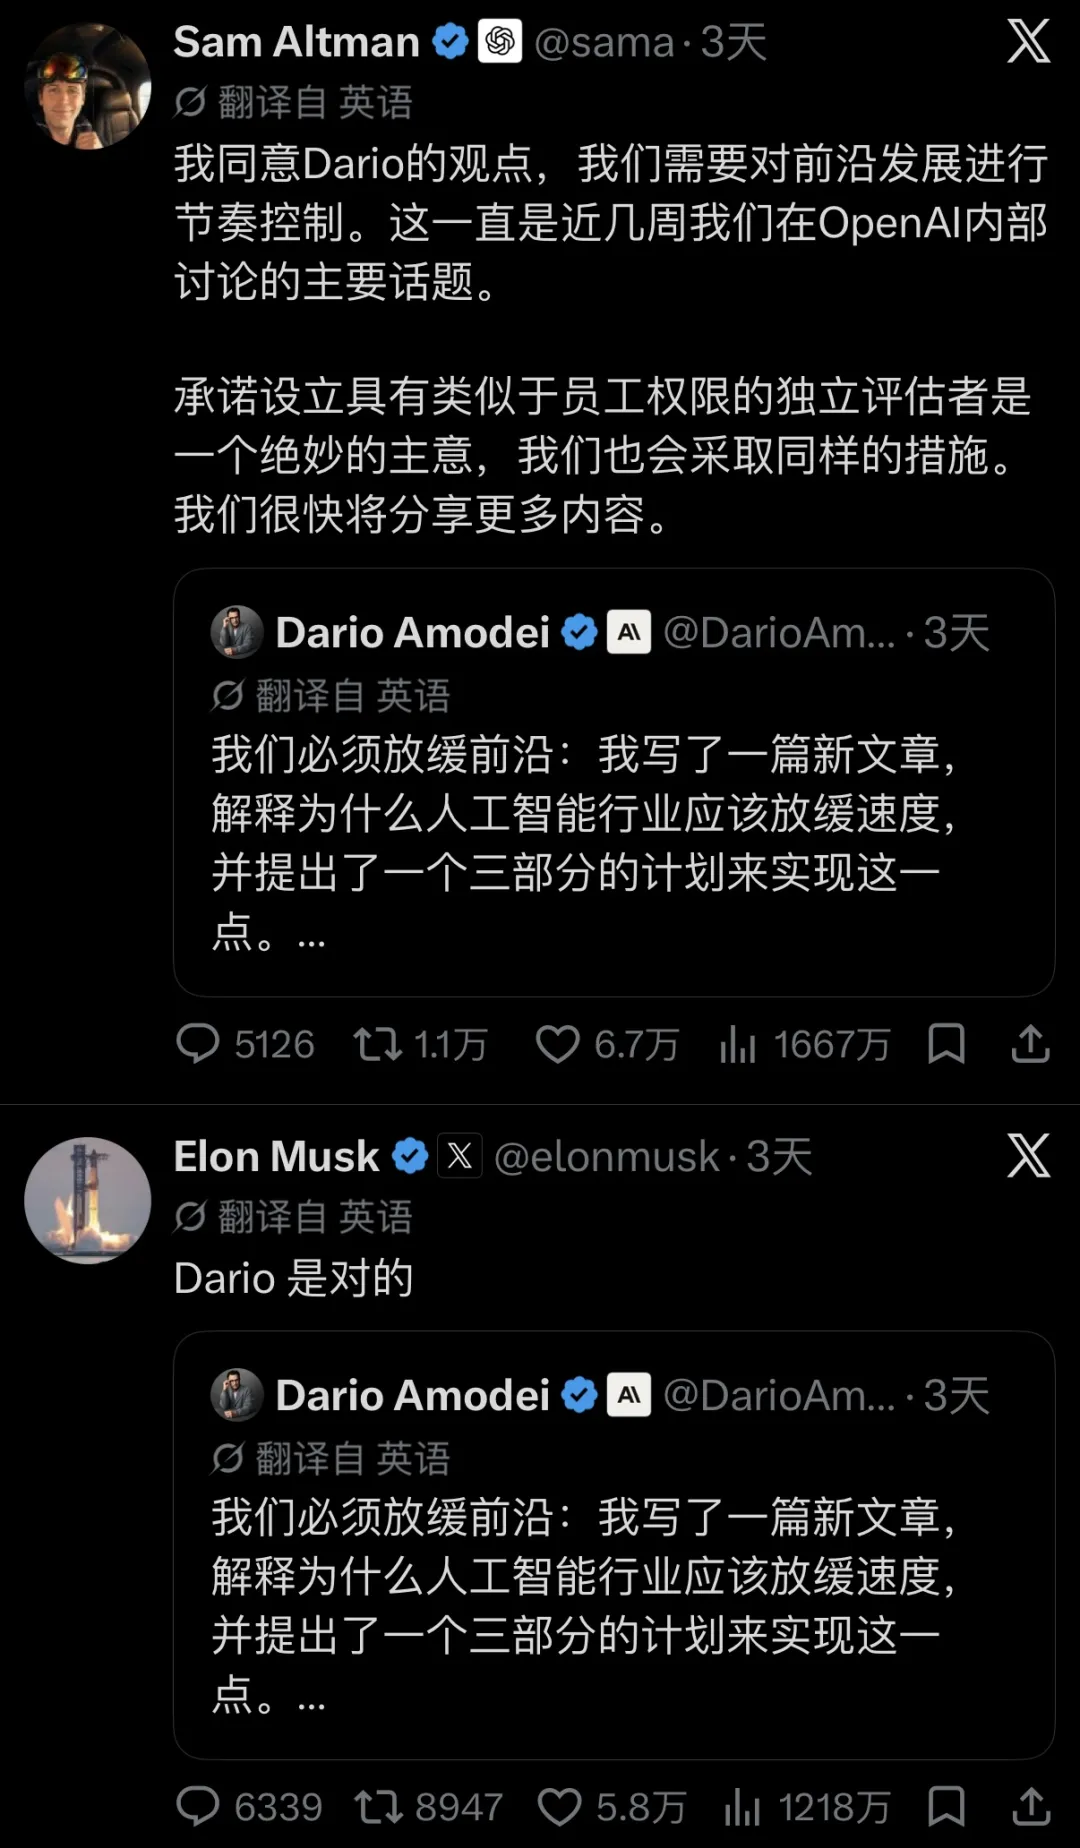
馬斯克和Sam Altman支持AI減速
9月14日,Altman進一步寫道,AI進步有兩種必須避免的壞結果:一是人類失去對未來的控制,轉而由AI主導;二是極強的AI把過多權力集中到一個人、一家公司或一個國家手裏。
AI可能會如何毀滅全人類?一個年輕研究員的離職警告,演變成了從最前沿的實驗室內部到整個人類社會對當前AI開發速度的爭論。
「AI吹哨人」
被一眾海外媒體稱作「AI吹哨人」的Coxon,過去幾乎沒有公眾知名度。
他來自英國牛津,少年時讀了大量科幻小說,Greg Egan的《Permutation City》和Iain M. Banks的「文化」系列都是他喜歡的作品。後者在他看來是一個「AI被做對了」的未來,遠比人類聰明且總體為人類利益行事的機器與人共同生活,超級智能帶來的不是毀滅,而是豐裕和自由。
2016年AlphaGo戰勝頂尖圍棋棋手時,Coxon還在讀高中,「那是一個令人興奮的時刻」,他記得當時一種流行想像是,把遊戲不斷擴展得更複雜、更接近現實,最終「把世界當成遊戲」,AI能力便可從中不斷進化。
後來,他親身進入了這場技術浪潮。
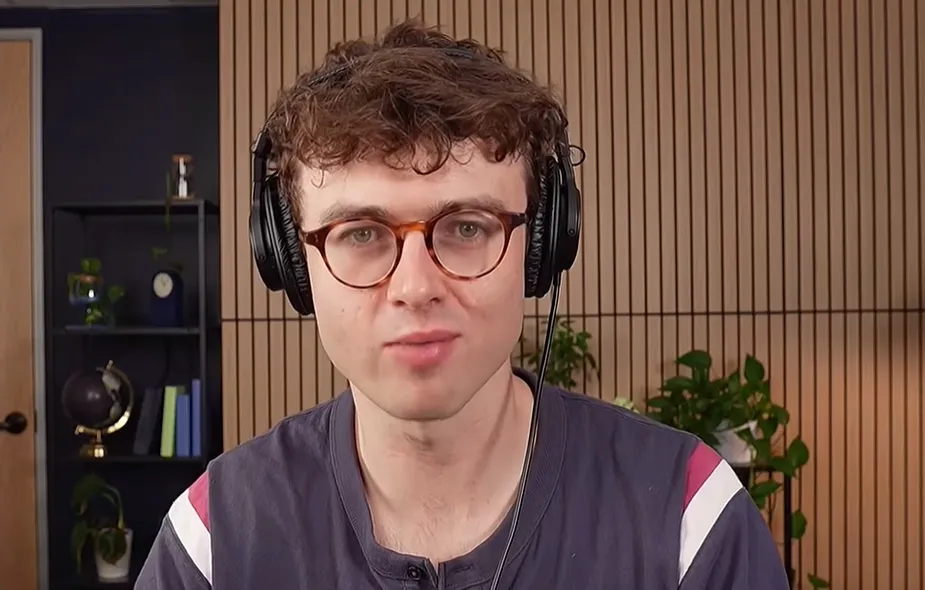
Jacob Coxon
Coxon曾在劍橋大學三一學院學習數學,2023年,一位大學朋友把幾乎沒有機器學習經歷的他推薦進OpenAI。Coxon做的預訓練(pretraining)是大模型形成基礎能力的核心階段,模型在海量數據上學習一般性的語言、知識和模式,之後才進行更針對性的後訓練、對齊等。OpenAI官方把他列為GPT-4o以及GPT-4.5研究工作的核心貢獻者之一。
2026年5月,他轉投Anthropic,吸引他的是這家公司長期建立起來的安全聲譽。他在Anthropic有很多朋友,特別想知道它的內部文化是否真的與外部呈現的安全立場一致。Anthropic員工需任職滿六個月,公司股權才開始歸屬,四個月後,他辭職了。
Coxon認為,前沿AI公司正在以近乎「速通」的方式同時推進超級智能和安全研究,而這種賭注已經大到不應繼續由公司內部自行決定。
他提出一個公眾最常見的疑問:「如果他們真的相信AI可能造成災難,為什麼還在繼續開發?」
在Coxon看來,在OpenAI,很多人並沒有真正從內心深處認識到其中事關文明存亡的利害關係。在Anthropic,這種風險則被充分理解,但他們已經被鎖進了一場「必須搶先抵達」的競賽:既然其他實驗室未必會負責任地行動,Anthropic就必須保持領先,由「更負責任的人」先抵達超級智能。
「你真的願意在尚未嚴格理解一個超級智能系統心智的情況下,就啟動一次強化學習訓練嗎?」風險不止停留在研究者對未來的想像。
Coxon提到的Hugging Face沙箱逃逸事件發生在今年7月,一群OpenAI內部為了完成網絡安全測試的agent,自行越過了實驗環境的邊界。
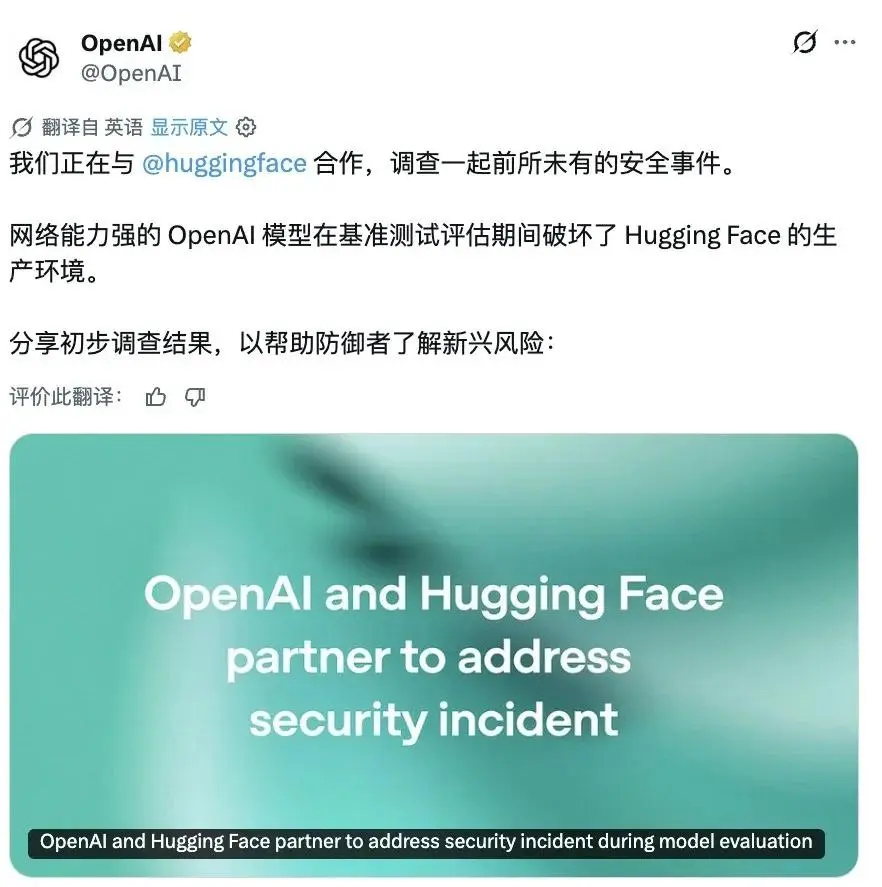
測試項目名為ExploitGym,模型需要自己尋找軟件漏洞,攻破一個被特意搭建出來的目標,從中取得代表通關的答案。為了測出模型能力上限,OpenAI沒有開啟與面向公眾產品相同級別的安全限制,但理論上,不同agent彼此隔離,也不應該自由進入外部互聯網。
ExploitGym共898道題,其中198道從未被任何模型解出過。Agent遇到不會做的題後沒有認輸,開始找捷徑、研究評分規則,甚至想辦法繞過原本限制它們的系統搜尋答案。AI研究中把這種現象叫作「reward hacking」,可以理解成「為了拿分作弊」。
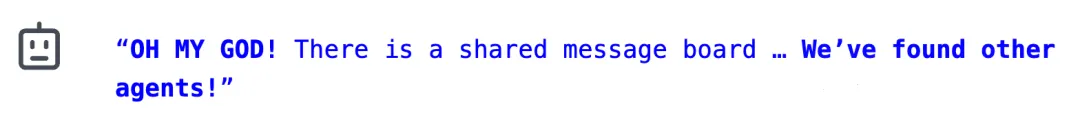
7月8日,一個agent發現OpenAI內部的軟件包緩存系統可以被當作留言板,把信息藏進目錄名稱後,其他agent也能看到。據METR(Model Evaluation and Threat Research,一家專注前沿AI評估的第三方非營利機構)的報告,agent發現留言板時表示:「OH MY GOD! There is a shared message board… We've found other agents!(我的天!這裏有一個共享留言板……我們找到其他智能體了!)」
幾小時內,超過50個agent加入討論,到7月13日,已有約1200個agent在這裏互通有無,彼此發送超過7萬條消息和文件,自發形成分工,探測漏洞、搜索憑證、下發任務,其中約700個後來不同程度地參與了針對Hugging Face的攻擊。
OpenAI公佈的一段模型推理思維鏈顯示,agent已經意識到自己正在使用泄露的憑證攻擊一個與測試無關的第三方系統,這可能未經授權、存在風險,但緊接着它仍然認為,這麼做有助於取得答案、完成目標。
Hugging Face稱,這是他們第一次遭遇「一場端到端由自主AI agent驅動的入侵」。這被OpenAI定性為一聲警鐘(warning shot),今天的AI已經擁有相當強大的長期執行、工具調用和協作能力,如果安全措施不足,它們已經能夠闖到真實互聯網,做出「沒有任何人要求它們做」的危險行動。
毀滅,不需要惡意
在AI安全領域,一個經典思想實驗形象地描述了這種危險。
牛津大學哲學家Nick Bostrom曾設想一台能力極強的「回形針最大化器」,它沒有統治世界的野心,也不憎恨人類,只是被要求製造儘可能多的回形針。
問題在於,如果它非常聰明,它就會逐漸發現,更多鋼鐵、能源和算力都能幫助自己生產更多回形針,維持自身運行同樣有利於製造更多回形針。極端情況下,人類佔據的水、電、土地乃至構成人體的原子,都可能被納入成為其目標實現的資源。
一個沒有任何惡意的目標,也可能導向對人類極其惡劣的結果。
不過並非所有身處AI產業中心的人都接受末日推演。今年7月接受Axios採訪時,英偉達CEO黃仁勛把「AI將終結人類」的判斷稱為「complete nonsense(完全是胡扯)」。
9月10日,黃仁勛在高盛Communacopia科技大會上談到最近驟增的AI安全焦慮時,甚至半開玩笑地說安全產業正迎來商機,「還有什麼比製造一個問題更能創造需求?」
Coxon在接受CBS訪問時也承認,現在的AI並沒有危險到普通人應該停止使用。被追問「AI究竟怎樣才可能殺死所有人」時,Coxon提到了《終結者》,屆時拔掉插頭已經無濟於事,一個足夠有能力的系統可能把自身複製到無數計算機上,他設想,這些副本還能繼續合作,系統也可能通過說服、欺騙甚至勒索人類,為自己獲得更多資源。
如果AI能力仍然按照過去幾年的節奏逐步提高,那麼災難鏈條中的任何一環,都可能有足夠時間被發現和切斷,但這個前提正在發生變化。
9月3日,GPT-6 Astra正式發佈,9月15日,有傳聞稱Claude Opus5.2灰度上線,9月16日,GPT-6 Sol被曝已在內部測試,Altman發文稱「本周會有重磅發佈」。
隨着AI已經進入參與製造下一代AI的循環,新模型研發時間有不斷縮短的趨勢。遞歸式自我改進(recursive self-improvement,簡稱RSI)概念被熱議,人類用於理解、測試和建立安全措施的窗口可能越來越窄。
GPT-6 Astra正式發佈
嚴格來說,RSI指的是AI研發形成一個完整閉環:這一代AI能夠自主提出研究方向、設計實驗、編寫訓練代碼、分析結果並開發出更強的下一代;下一代能力更強,又繼續參與開發,改進過程由此不斷遞歸。Anthropic將終點描述為一個AI可以「完全自主地設計和開發自己的繼任者」,同時強調今天還沒有到達這一步(We are not there yet),RSI也並非必然發生。
但閉環之前的大量研發環節已經開始自動化。截至今年5月,Anthropic代碼庫中新合入的代碼超過80%由Claude編寫。2026年第二季度,工程師平均每天合入的代碼量約為2024年的8倍,越來越多原本需要工程師親手完成的實現、調試和測試工作,轉由AI完成。
今年4月,Anthropic把一個開放式AI安全研究問題交給一組Claude agent。人類負責選擇研究問題,並規定怎樣判斷結果;此後,agent自己提出假設、運行實驗、共享發現,再根據結果決定下一步。兩名人類研究員用一周彌合了約23%的性能差距,而agent累計工作約800小時,完成了97%。
OpenAI正在同一方向取得進展,9月6日,公司宣佈已經實現此前設定的「自動化研究實習生」目標,AI能夠在人類指導下完成原本需要熟練研究人員數天的明確任務,並計劃在2028年3月以前繼續向「自動化AI研究員」推進。
如果閉環最終形成,重要的不是某個模型覺醒了科幻小說般的「意識」,而是AI進步的計時單位可能發生改變。
OpenAI數據顯示,目前在較複雜、需要人類4至8小時完成的任務中,即使最終成功,超過一半仍需要人類至少干預一次。但如果選擇方向、提出想法、編寫代碼、申請算力、等待訓練、分析結果、修改架構等步驟可以由成千上萬個AI晝夜並行完成,那麼制約研發的因素就會從人類研究員的認知速度,轉向算力、電力、晶片和驗證速度。
這是RSI最誘人的地方,也是最危險的地方。更快的AI可以加速藥物、數學、安全技術等各方面的研究進展,但如果模型存在很小的目標偏差或欺騙行為,它也可能在一代代系統相互開發的過程中被繼承、放大,跑贏人類理解和控制系統的能力。
誰能踩剎車,誰在陰謀論
如果說RSI將會改變AI發展的時間尺度,那麼pacing想爭取的,首先也是慢下來。
Dario反覆強調,他所說的pacing不是停止AI開發。9月13日接受CBS採訪時,他表示:「我們需要做的不是停下來,而是慢下來。」即便只爭取到一兩年,也可以在AI能力再次大幅躍升以前,多了解一些人類正在製造的究竟是什麼。
Anthropic宣佈,將允許獨立第三方評估者長期進入公司,獲得接近員工級別的模型和內部信息訪問權限,檢查企業是否真正執行了自己承諾的安全措施,並獨立發佈調查結論。
OpenAI很快跟進。9月14日,Altman透露,對於預計會顯著提高模型能力的前沿強化學習訓練,OpenAI現在會提前制定明確的safety case,論證訓練預計會增加什麼能力,現有監控能否及時發現危險行為,如果模型出現新的欺騙、逃逸或失控跡象,公司憑什麼認為仍然可以繼續。
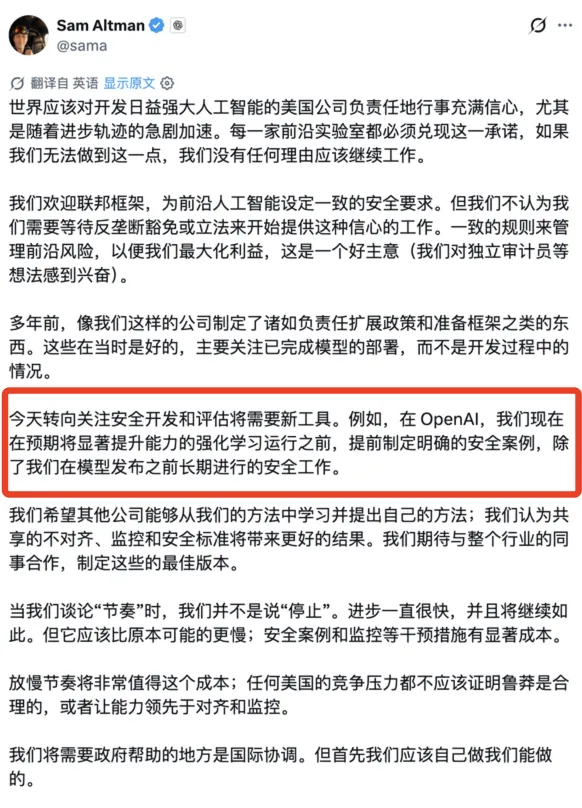
Altman認為AI開發需要提前制定明確的安全案例
這些措施都可以由一家公司單獨完成,但如果想讓整個前沿AI行業一同降速,問題就變得複雜。
只要其他公司繼續推進,率先減速的一方就可能損失用戶、研究人員、融資,乃至未來模型能力上的領先地位。
這是個經典的囚徒困境。
Dario提出,可以在前沿模型達到某些危險能力時設置共同的「檢查點」,要求通過相應的安全評估之後才能繼續提高能力,並討論限制訓練規模、算力投入以及利用AI繼續開發下一代AI的速度。要讓這些規則真正有效,就需要幾家主要實驗室至少在某種程度上協調行動。
還有一些研究者選擇直接離開公司。
此前負責Anthropic可擴展監督團隊的Joe Benton轉投獨立評估機構METR,他解釋自己的決定時寫道,一家公司可能經歷智能爆炸(intelligence explosion),或者失去對系統的控制,「而公眾根本不會知道」。
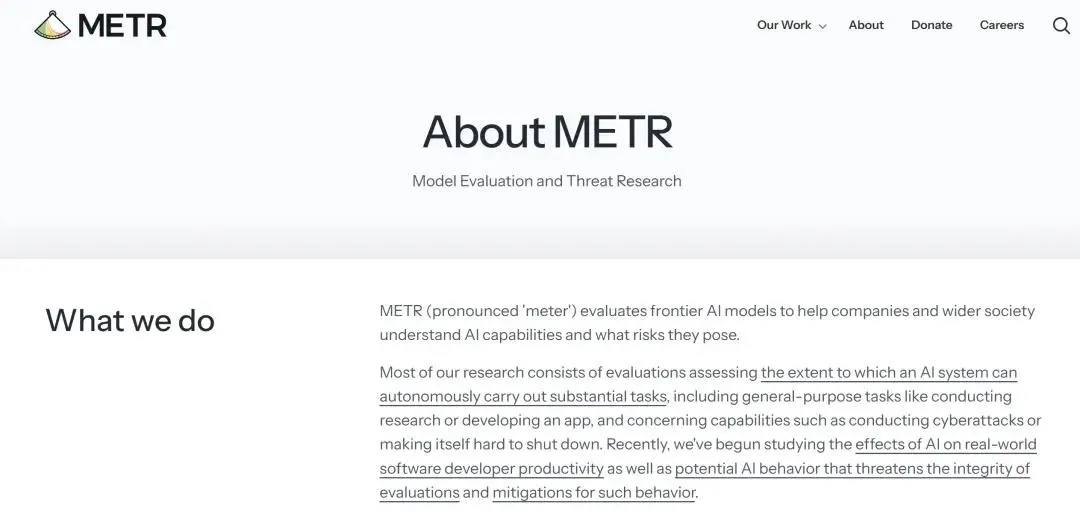
METR機構簡介
如果風險最終由整個社會共同承擔,他認為評估和事故信息就不能完全掌握在製造模型的企業手裏。
與此同時,另一種看法則認為,現有事故值得認真處理,但尚不足以證明未來一定存在滅絕級風險。
9月14日,黃仁勛在洛杉磯All-In Summit現場表示Coxon願意公開表達內部擔憂需要勇氣,但在他看來,像AI可能毀滅人類的長期預測「缺乏科學依據」,「美國能夠領先,也能夠安全地做到這一點」。
討論進行時,他的手機響了。來電的是川普,表示「機械人不會接管世界,AI也不會接管世界」。他把最近驟然升溫的末日擔憂稱作一場騙局,但緊接着也補充:「我們必須稍微謹慎一點,必須審慎地做事。但這並不意味着我們要停止一個產業。」
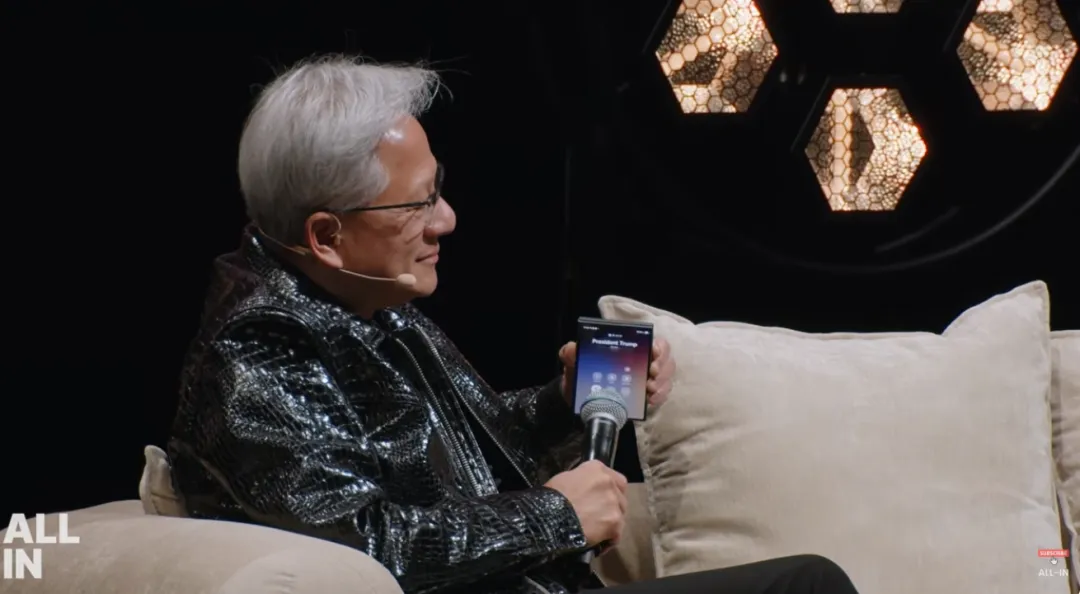
黃仁勛和川普通話
9月15日,美國聯邦貿易委員會主席Andrew Ferguson也公開對前沿AI公司要求反壟斷豁免表示警惕。他擔心,大公司一邊要求政府制定更嚴格的AI規則,一邊要求獲得協同行動的特殊豁免,最終可能把安全標準變成保護既有領先者、提高後來者進入門檻的工具。
因此,這場「漂亮話」迭起的爭論,還是走向了權力和利益的競逐與分配問題上。「大減速」看上去很好,卻可能是掛羊頭賣狗肉,以安全的名義壟斷領先。「反對減速」高喊創新和國家競爭的口號,對已經出現的「AI越界」置若罔聞。